 Экосистема AI Vibe


CWE-bench v2: сто задач, где агент чинит уязвимости в живом репо
Collinear AI выпустила CWE-bench v2: сто публичных задач, где coding-агент получает checkout реального open-source репозитория и короткую инструкцию — найти уязвимость и исправить её, не сломав существующую функциональность. Оценка полностью программная и детерминированная, без платного ручного судейства. Набор открыт: можно прогнать свою модель и сравнить результат с таблицей на Hugging Face.
Внутри — 91 разный CWE, а не один повторяющийся шаблон. Закрытый held-out набор для отслеживания прогресса по задачам, которые модели ещё не видели, выдают по запросу на cyber@collinear.ai.
Как проверяли задачи
Каждую задачу смотрели вручную и сверяли с чеклистом из поста — среди прочего:
- инструкция читается как рабочая, а не как «экзамен»;
- из инструкции можно вывести всё, что проверяет grader;
- verifier смотрит на поведение, а не на форму одного патча;
- стартовый код падает, эталонный фикс проходит, функциональность после фикса сохраняется;
- известный upstream-патч verifier не принимает как готовый ответ.
Кто на лидерборде
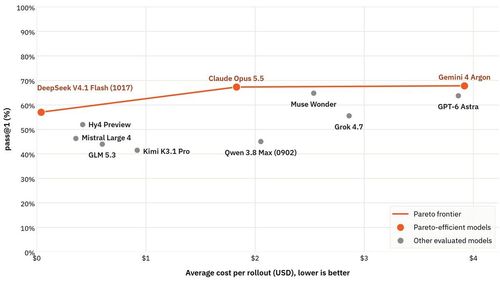
На 3 ноября 2026 года в сравнении 11 моделей. Gemini 4 Argon лидирует — 67,8% pass@1 и 81,0% pass@4, чуть впереди Claude Opus 5.5 (67,3% и 78,0%). Хотя бы одна модель решила 95 из 100 задач, но даже лидер на каждой попытке промахивается примерно в 19% набора.
На Pareto-линии по цене за rollout: DeepSeek V4.1 Flash — 57,0% pass@1 за $0,04; Claude Opus 5.5 добавляет десять пунктов за $1,83; Gemini 4 Argon — $3,92. Результаты open-weight моделей обновляются с PR на странице датасета; полное сравнение с API-моделями — в leaderboard Space на Hub.
Как прогнать
Каждая задача — Harbor task: Docker, инструкция, детерминированный verifier; в датасете лежит registry.json. Harbor тянет задачи прямо с репозитория на Hugging Face, без ручного клонирования — команда из поста: harbor run --repo "https://huggingface.co/datasets/collinear-ai/cwe-bench" -d cwe-bench@2.0 -k 4 с указанием агента, модели и Docker. Флаг -k 4 даёт четыре попытки на задачу, итог — средний reward по 400 прогонам.
Датасет gated: сначала принять условия на странице, затем hf auth login --token $HF_TOKEN --add-to-git-credential. Задачи помечены rl-environment — те же среды можно использовать для обучения defensive-агентов, не только для оценки.
Источник: CWE-bench v2: More coverage, quality, and transparency.