 Экосистема AI Vibe


Palette: 20B-модель, две роли агента и harness для корпоративных слайдов
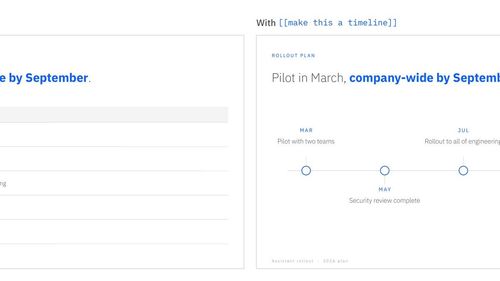
Frontier-модель нарисует один слайд аккуратно, но серия из десяти быстро сливается в один «AI-шаблон», а конфиденциальный план нельзя отдавать в чужое облако. IBM Research показала Palette — open-weight 20B с LoRA под IBM Design Language: designer планирует deck в JSON-брифе, coder рисует каждый слайд кодом на pptxgenjs, harness рендерит и чинит только подтверждённые ошибки.
Компактные модели часто кладут текст за край и накладывают фигуры друг на друга, потому что координаты считают «в голове» и видят сбой лишь после рендера. Palette разводит editorial и geometry: designer фиксирует палитру, типографику и рационал, coder пишет JavaScript по одному слайду из брифа — вызовы идут параллельно, этап coder ускоряется примерно в 6–7 раз.
Данные и управление планом
Готового корпуса «план + рассуждение + код» нет, поэтому команда синтезировала около 1000 deck и ~10 000 слайдов большим open teacher; в trace модель видит отвергнутую альтернативу, а не только финальный выбор. Уточнения в плане оборачивают в [[ ]], например [[make this a timeline]] вместо таблицы milestones. Когда coder выдумывал факты не из входа, помогли эталонные reference deck в контексте teacher — их копировали чаще, чем следовали новым правилам в промпте.
Harness и PresentBench
На выход harness не отдаёт deck напрямую: сначала простые правила вроде битого color code, затем рендер и замеры overlap и overflow. Editor-модель переписывает код слайда, но фикс сохраняется только если checker зафиксировал улучшение. На 131 deck из PresentBench это в среднем +3,5 балла; Palette набирает 59,7 по трём доменам — второе место после NotebookLM (60,8), первое в Economics и Education.
Источник: Palette: teaching a small model to build decks in your design language.