 Экосистема AI Vibe


Роутер моделей в harness: −64% к счёту без просадки по PR
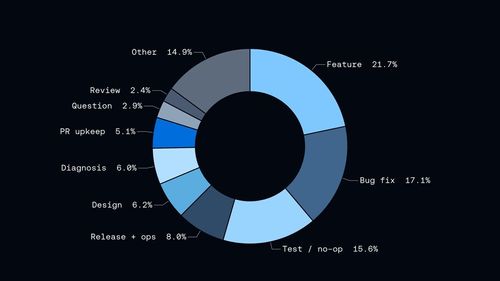
LangChain встроили роутер моделей в harness coding-агента Open SWE , не в общий LLM-шлюз. На первом сообщении выбирается уровень модели с учётом промпта агента, инструментов и домена задачи , того контекста, которого у шлюза обычно нет. В A/B на 973 интерактивных тредах медиана расхода на LLM за тред упала на 64% без заметной просадки по качеству. Счёт на coding-агента у LangChain рос быстро, у клиентов картина была та же. Полигон , Open SWE из Slack и веб-UI: вопросы по репозиторию и запросы на правки. Неделю тредов из LangSmith traces разметили классификатором: новые фичи , 22%, багфиксы , 17%, тесты и no-op , 16%. Длинные дорогие треды чаще совпадали с feature work, короткие , с тестами и релизными процедурами. Три уровня и выбор на старте треда По кривой Artificial Analysis Intelligence Index: fast , GLM-5.3-Flash (xhigh), balanced , GPT-5.6 Sol (medium), performance , GPT-6 Astra (low). Базовый промпт роутера: наименее дорогая модель, которая по вашим критериям справится с задачей; критерии tier , короткие plain-language описания типов работ. Классификатор читает первый запрос пользователя; позже его заменили на decision-модель Jev , классификация стала почти в 50× быстрее. Middleware меняет модель агента без переписывания остального стека. Merged PR , 29.2% routed против 27.3% control (p = 0.49); открытие PR , 38.9% против 39.6% (p = 0.82). Медиана счёта на тред $0.94 против $2.61 на «всегда GPT-6 Astra». Среди routed 56% ушли на balanced, 34% на fast, 10% на performance; медиана fast-треда , $0.097, balanced , $1.50, performance , $2.88 , разброс порядка 30×. Контроль «только fast» сняли меньше чем за сутки , инженеры сразу пожаловались на качество. Offline evals и live A/B дополняют друг друга: для coding-агента сильный сигнал , merged PR, плюс редкий thumbs up/down на trace в LangSmith. Источник: How to Build a Model Router in the Harness .