 Экосистема AI Vibe


LFM3 от Liquid AI: один бэкбон, шесть модальностей и дообучение на одной GPU
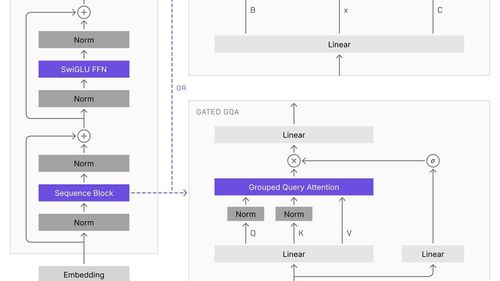
Liquid AI выпустила LFM3 — шесть моделей класса ~2B от общего бэкбона LFM3-1.7B-Base: текст, зрение с видео, аудио, omni и decision-ветки d1-2B и d1-omni-2B. Текстовую LFM3-1.7B позиционируют под локальных агентов с вызовом инструментов: вес около 1 GB в 4-bit, окно 256K токенов; каждую ветку можно дообучить на одной GPU под свои данные.
На агентных бенчмарках прирост заметнее, чем в среднем по метрикам: LFM3-1.7B обходит LFM2.5-2.6B при на 35% меньшем числе параметров, а на WebArena-Verified набирает 38.42 против 3.02 у предшественника. Post-training заточен под harness Hermes Agent, Pi и OpenClaw.
Что изменилось относительно LFM2
- Больше качества на параметр за счёт tri-hybrid архитектуры и нового рецепта обучения.
- Одна база для текста, зрения, аудио, omni и decision-моделей — не один «универсальный» гигант.
- Упор на edge: свои vision- и audio-энкодеры быстрее прежних SigLIP2; текст помещается в ~1 GB в 4-bit.
- Специализация без кластера: fine-tune на одной видеокарте под терминологию и среду деплоя.
Бэкбон искали hardware-in-loop на 14 связках — от телефона и Raspberry Pi 5 до облачных GPU и Qualcomm Hexagon NPU. Pre-training — 22T токенов; финальные 3.5T mid-training с долей agentic traces и tool calls растягивают контекст до 256K.
Линейка моделей
- LFM3-1.7B — текст в текст, structured outputs и база для доменного fine-tune.
- LFM3-VL-2B — текст, изображения и видео; средний балл по 62 vision-бенчмаркам вырос с 57.6 до 71.4 при 1.9B параметров против 3.1B у LFM2.5-VL-3B.
- LFM3-Audio-2B — голос, ASR, синтез и 18 языков; при стриминге time to first token до 50 ms.
- LFM3-Omni-2B — первый omni в линейке: картинки, видео и аудио на входе, текст и речь на выходе.
Запуск через transformers
Текстовую модель поднимают через pipeline("text-generation", model="LiquidAI/LFM3-1.7B", trust_remote_code=True) после pip install -U transformers. Для LFM3-VL-2B нужен transformers>=5.21.0 с torch и pillow; для LFM3-Audio-2B — transformers>=5.20.2, librosa и soundfile. В карточках на Hugging Face перечислены и другие inference-движки, в том числе llama.cpp для on-device VL.
Источник: Build specialized multimodal models with LFM3.