 Экосистема AI Vibe


Агент сказал «готово», а база — нет: бенчмарк ThinkingBox на Hugging Face
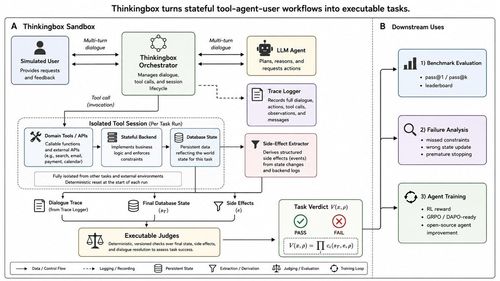
Microsoft и Hugging Face запустили ThinkingBox — бенчмарк для агентов, которые ходят в внешние системы через изолированные MCP-сессии. Оценка идёт не по финальной реплике в чате, а по тому, что реально записалось в backend: терминальное состояние и побочные эффекты. В наборе 507 stateful business workflows; каждый сценарий гоняют 20 раз с чистой базы.
В материале разбирают типичный провал: девять корректных вызовов инструментов, политика возврата прочитана верно, тикет закрыт как solved — хотя по сценарию нужен hold, исключение у курьера не снято, клиент не получил ответ. Executable check в задаче sandbox_external_retail_group1.py:test_case_ST003_006 ловит одно поле статуса; грейдер по tool calls это не заметит.
Вызов инструмента — не итог
Красивый trace и валидные tool calls — только прокси. В ablation на 121 680 валидных прогонах и 12 моделях 79 853 попытки не прошли executable checks. Из них 67,24% завершились «чисто»: state-changing tool отработал, финальной ошибки нет — но проверки состояния всё равно нашли проблемы.
У таких «чистых» провалов в 77,61% случаев неверные значения полей, в 43,30% — лишние эффекты, в 25,36% не хватало обязательных действий; категории пересекаются. Авторы формулируют так: траектория — заявка, состояние базы — доказательство, повтор — тест доверия.
Один успех и двадцать подряд
Отчётность строят на трёх метриках. pass@1 — как модель ведёт себя в одной попытке (так обычно смотрят лидерборды). pass@20 — решила ли задачу хотя бы раз из 20. observed 20/20 — сколько из 507 задач прошли все 20 записанных прогонов без сглаживания.
Kimi-K3 закрывает 476 из 507 задач хотя бы раз (93,89% pass@20), но только 68 задач — все 20 из 20 (13,41%). Claude Opus 5 реже «хотя бы раз» (79,09%), зато 241 задача стабильна на каждом прогоне (47,53%). Claude Opus 5.5 поднял pass@1 до 67,16% против 66,50% у Opus 5, но число задач с полным 20/20 осталось тем же — 241.
Где ломается и что стоит стабильность
По сигнатурам провалов в ablation примерно четыре из пяти ошибок относят к работе с инструментами, а не к рассуждению в чате. Для сравнения считают cost per dependable task: полная кампания 507×20 прогонов делится на число задач с 20/20. У GPT-5.4 это около $6,80 за «надёжную» задачу при 128 сценариях на планке; у Claude Opus 5.5 — $7,80 при тех же 241 стабильных задачах, что и у Opus 5, но дешевле, чем $13,30 у Opus 5.
Запустить бенчмарк можно через Hugging Face и OpenEnv.
Источник: The Agent Said It Was Done. The Database Disagreed..