 Экосистема AI Vibe


9 млн синтетических персон Nemotron: финансовый контекст без реальных клиентов
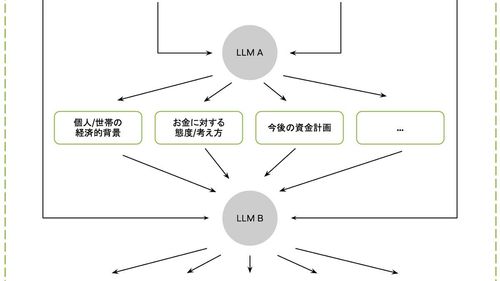
Elith и NVIDIA выложили Nemotron-Personas-Finance-Japan — открытый датасет с 9 млн синтетических персон на японском. Демография и домашние финансы заземлены на официальную статистику, реальных людей в данных нет; лицензия CC BY 4.0 с правом коммерческого использования.
Внутри — 1 млн строк по 9 персон в каждой и 50 полей на запись: от занятости и стадий жизни до домашних активов и финансовой грамотности. Объём — около 1,5 млрд токенов, примерно 750 млн из них — текст персон; порядка 950 тысяч уникальных имён и более 1600 категорий занятости. Генерацию вели через NeMo Data Designer и вероятностные NeMo SDG-PGMs, японский текст давала gemma-4-31B-it.
Куда это в агентном пайплайне
Коллекция Nemotron-Personas стыкуется с NeMo User Sim — симуляции можно гонять на распределениях, близких к реальности, без клиентских PII. Из релиза выделяют три практических сценария:
- Мультитуровые диалоги — персона как «семя» для человекоподобных транскриптов.
- Симуляция клиентов и оценка продажных или сервисных разговоров.
- Проверка смещений: город и село, возраст, образование, уровень дохода.
9 ноября 2026 года в том же анонсе появился Nemotron-PII-Japan: 100 тысяч синтетических деловых документов с размеченной персональной информацией — для обучения и теста детекции и редактирования PII. Основной набор тянется одной строкой с Hugging Face Datasets:
from datasets import load_dataset
ds = load_dataset("nvidia/Nemotron-Personas-Finance-Japan")
Источник: Nemotron-Personas-Finance-Japan: A Synthetic Dataset Capturing Japan's Demographics and Financial Context.