 Экосистема AI Vibe


Open TTS Leaderboard: объективные метрики вместо arena-голосования
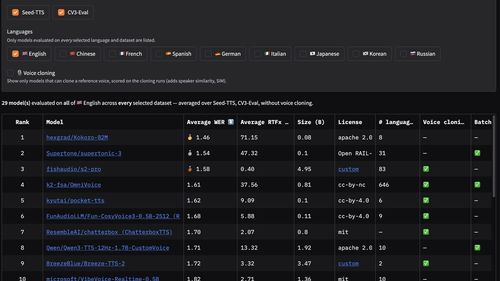
На Hugging Face Hub уже больше 8000 моделей синтеза речи, а arena-лидерборды — TTS Arena v2, Artificial Analysis, Voice Arena — не успевают за темпом релизов. Голосование и Elo по Bradley–Terry занимают недели; open-weights там почти не видны: на Artificial Analysis открытых моделей 16 из 92, на Voice Arena картина похожая — API подключают ключом, веса должен поднять оператор арены.
Hugging Face запустила Open TTS Leaderboard: один прогон модели сжимается с пары недель до пары часов. Лидерборд не отменяет человеческое предпочтение (MOS и MUSHRA по-прежнему эталон), но отсеивает шум и подсказывает аренам, какие open-модели имеет смысл включать в сравнение.
Три оси метрик
- Разборчивость — WER и CER между текстом промпта и транскриптом аудио через Qwen3 ASR (лидер Open ASR Leaderboard).
- Скорость — обратный real-time factor при батчевом офлайн-инференсе на GPU H200 и time-to-first-audio для стриминга при batch size 1 на H200 и CPU.
- Клонирование голоса — косинусная схожесть эмбеддингов WavLM между выходом и референсом.
Языки и клонирование
По умолчанию рейтинг — macro-average WER на английских сплитах Seed TTS Eval и CV3 Eval (zero shot). В топе — hexgrad/Kokoro-82M, Supertone/supertonic-3 и fishaudio/s2-pro; Pareto-графики показывают баланс WER, RTFx и размера весов.
Другие языки переключают отдельно: у Seed TTS Eval есть аудио только для английского и китайского, остальное — CV3 Eval. Сильные мультиязычные варианты — k2-fsa/OmniVoice, fishaudio/s2-pro и FunAudioLLM/Fun-CosyVoice3-0.5B-2512. Режим Voice cloning добавляет колонку SIM; у bosonai/higgs-tts-3-4b и openbmb/VoxCPM2 средний WER часто лучше, когда дают референсное аудио.
Стриминг и прослушивание
Вкладка Streaming ранжирует по TTFA — задержке до первого воспроизводимого звука. Для моделей со стриминговым API это время до первого чанка; для остальных — до готовой фразы. Прогон: 50 английских промптов из CV3-Eval, batch size 1, дефолтный голос; первые 3 запуска — warm-up, в таблице медиана. Отдельно H200 и CPU; для стриминга авторы выделяют kyutai/pocket-tts.
Вкладка Listen сравнивает те же аудио, что стоят за цифрами: язык, датасет, клонирование, выбор моделей или случайная пара. Голосовать можно с аккаунтом Hugging Face; скрипты оценки обещают открыть по аналогии с Open ASR Leaderboard.
Источник: Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning.