 Экосистема AI Vibe


GPT-6: кэш промптов стал умнее — до 90% на повторном контексте
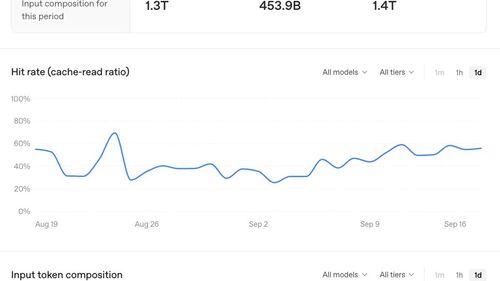
Долгие агенты на GPT-6 шлют в API цепочку запросов с одними и теми же инструкциями, схемами инструментов и накопленным контекстом. OpenAI докрутила под это кэш промптов: в семействе GPT-6 выше доля попаданий по умолчанию, общий префикс можно переиспользовать в окне 30 минут, на закэшированные input tokens — скидка до 90%.
GitHub Copilot пишет, что за несколько месяцев на миллиардах запросов к моделям OpenAI доля prompt tokens, которые обрабатывают «с нуля», упала больше чем на 50% относительно прежнего baseline. Для агента, который крутится часами, это и скорость первого токена, и счёт за inference.
Дашборд и диагностика
Prompt Caching Dashboard показывает, какая часть входа отдаётся из кэша: hit rate во времени и график composition — cached против uncached tokens. Если после деплоя кривая просела, prompt caching diagnostics сравнивает запрос с недавним ответом и называет, что сломало reuse: модель, tools, настройки или сам input.
В примере из документации причина — tools_changed: и comparison_reusable_tokens, и cache_missed_tokens по 5629. Видно масштаб одного промаха, а не только итог в биллинге.
Настройки, если дефолта мало
- Явные breakpoints — выбираете, какие префиксы кэшировать; в обновлённом guide — срок жизни префикса и влияние смены tools.
- Reasoning effort на GPT-6 можно менять между ответами через
configuration_update, не трогая effort на уровне запроса — тяжёлая задача и лёгкий follow-up в одной сессии без сброса кэша. - Стабильные tools — не выкидывайте definitions:
allowed_toolsограничивает вызов,tool_choiceсо значением none отключает вызов без удаления схем; новые указания добавляйте developer messages в конец контекста. - Prewarming — общие инструкции и tool definitions можно прогреть при старте приложения, до первого вопроса пользователя.
У Strawberry Browser после дашборда и диагностики hit rate вырос на несколько процентов, расходы снизились на 20%; при неожиданных сбоях кэша ловят алерты и разбирают причину через Codex agents. Breakpoints позволяют держать стабильный хвост в кэше и форкать фоновые ветки диалога, почти не дублируя shared context.
Источник: Better prompt caching for GPT‑6.