 Экосистема AI Vibe


DSpark для LFM2.5-VL-3B: до 3.13× быстрее decode на Mac без смены ответа
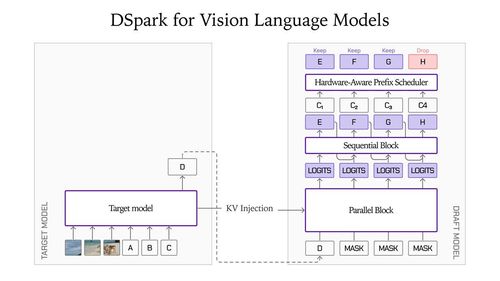
Liquid AI выпустила экспериментальный черновик LFM2.5-VL-DSpark для open-weight vision-модели LFM2.5-VL-3B. К целевой модели подключается speculative decoding: лёгкий drafter предлагает блок токенов, основная их проверяет , при greedy-генерации текст совпадает с запуском без черновика. Архитектура повторяет текстовые LFM2.5-DSpark: drafter опирается на hidden states с фиксированных слоёв цели, патчи изображения и текст сходятся в одно представление до этих слоёв. В релизе , упрощённый attention-only drafter на четыре слоя; на инференсе рекомендуют block size 8 или 9 под железо. Скорость и память Черновик , около 280M параметров, это +8.9% к 3B target. На бенчмарке MMSpec (VQA, captioning, chart VQA, multi-turn и др., block size 8) на M5 Max через MLX decode быстрее в 2.30×, 3.13×, сквозная задержка до 2.62×. На M3 Ultra с llama.cpp decode 1.57×, 2.14×, end-to-end до 1.77×; на H100 decode до 2.66×, end-to-end до 2.27×. Запуск SGLang , сборка с DSpark для LFM2 (PR #40651): --speculative-algorithm DSPARK , draft-модель LiquidAI/LFM2.5-VL-3B-DSpark . llama.cpp , PR #29339, --spec-type draft-dspark , --spec-draft-n-max 8 . MLX-VLM , PR #2280: mlx_vlm.server --model LiquidAI/LFM2.5-VL-3B --draft-model LiquidAI/LFM2.5-VL-3B-DSpark . Веса на Hugging Face в Safetensors и GGUF. В ответах сервера в таймингах обычно видны draft_n и draft_n_accepted , по ним видно, насколько черновик совпадает с target. Где прирост съедается Speculative decoding ускоряет только decode, не vision encoder и не prefill. На edge доля этих этапов в end-to-end выше, поэтому даже сильный прирост на decode даёт скромнее выигрыш «от запроса до последнего токена» , тот же потолок, что описывает закон Амдала. Источник: Accelerating vision-language models with LFM2.5-VL-DSpark .