 Экосистема AI Vibe
VocabX: узкий словарь Qwen3-4B дал −77% стоимости inference без смены весов
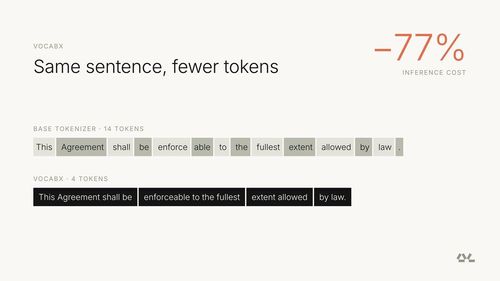
Узкая задача на Qwen3-4B не обязана тащить за собой универсальный словарь на 151 669 записей: при decode модель на каждом шаге прогоняет весь выходной слой, даже если ответ всегда один и тот же JSON. На Hugging Face команда Dharma-AI описала VocabX — пересборку токенизатора под цену токена в поле (промпт, ввод, ответ), а не под частоту в корпусе.
Проверяли на продакшен-грейдере португальских сочинений: базовая модель, те же данные и тот же рецепт дообучения, менялся только словарь. Строк в выходном слое стало около 65 000 вместо ~152 000, средний ответ — 101 токен вместо 350. Семь вариантов гоняли по 500 запросам на RTX 5090 через vLLM; по замеренному runtime стоимость упала на 77,0%, bench score — с 0,703 до 0,810.
Генерация дороже чтения
Ввод модель прогоняет пачкой (prefill), ответ пишет по одному токену (decode) — и там упираешься в пропускную способность памяти GPU. В их грейдере один записанный токен в среднем стоил в 7,4 раза больше прочитанного; коэффициент плавает от батча и длины контекста, но вывод простой: резать повторы в ответе выгоднее, чем равномерно жать весь текст.
Отдельно давит последний слой: на каждом шаге decode он выставляет оценку по всему словарю. Запись, которую задача почти никогда не пишет, всё равно участвует в проходе.
Как собирают словарь
- Вес поля — кандидат в словарь оценивают с множителем: для грейдера токен в ответе учитывали в 7,4 раза тяжелее, чем во вводе.
- Субслова и macro token — пересобирают нарезку слов и добавляют целые повторяющиеся куски: JSON-конверт, имена компетенций, шаблонные фразы.
- Пять miners — отдельные поиски повторов в корпусе; без полного набора сжатие на грейдере, по их метрике, просело бы на 55,6 пункта.
Первый словарь слил оценку компетенции и окружающий JSON в один macro token — компактно, но bench score упал до 0,689. Когда оценку вынесли в отдельный токен (+2 токена на ответ), качество вернулось к 0,810, а экономия по runtime оказалась выше, чем у «слитой» схемы: 77,0% против 73,3%. Сжимать шаблон можно; токен, через который модель принимает решение, — рискованно.
Источник: How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications.