 Экосистема AI Vibe


Fine-tuning на GPU: FLOP-оценка против реального wall-clock на 272 SFT
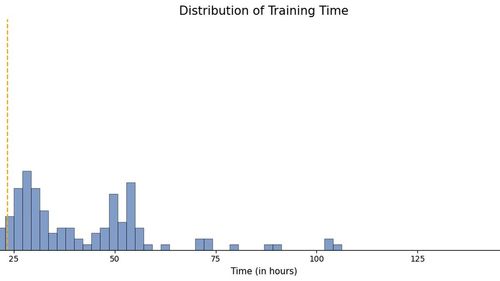
Когда планируешь SFT на общем кластере, «девять часов по FLOPs» и смена, которая уезжает на завтра , разные истории. Dharma-AI сравнила 272 продовых прогона на NVIDIA H200: классическая формула почти не объясняет реальный wall-clock, а предиктор по конфигу до выдачи GPU в медиане промахивается примерно на полчаса. На FLOP baseline с лучшим MFU R² = 0.31 и MAE 12.41 ч; CatBoost на тех же runs , R² = 0.98, MAE 1.71 ч, медиана ошибки 0.51 ч в 5-fold cross-validation. В логах суммарно около 7 382 GPU-часов. Измеряют время от момента выдачи GPU до завершения job, очередь не считают. Модели до 15 млрд параметров, LoRA и полный fine-tuning, стек Hugging Face Transformers и Unsloth; длительности от 1.6 до 172.4 ч (среднее 23.43, медиана 15.29) на пуле из 8, 32 H200 с соседними inference-нагрузками. Почему не сходится оценка по операциям Формула смотрит на цикл обучения , порядка 6·P·D делённого на пик GPU с MFU, обычно в диапазоне 30, 60%. До первого шага , setup, загрузка весов, токенизация; по ходу , eval и чекпоинты в object storage; на мультитенантном кластере всё это делит сеть и I/O с чужими job. MFU гоняли от 0.25 до 0.65: при 30% средняя ошибка всё равно выше 12 ч на прогонах со средней длительностью около 23 ч. Расширенный аналитический baseline Calculon (LoRA, GQA, bfloat16) в медиане даёт лишь ~11% наблюдаемого wall-clock , нормально как симулятор training loop, плохо как прогноз end-to-end. Что видит модель до старта Только submitted configuration: гиперпараметры, размеры датасета, идентификатор модели, число GPU , без runtime-логов. Производные про overheads: объём eval за жизнь job, число сохранений и параметров в чекпоинтах, токены на GPU; FLOP-оценка с MFU 0.45 идёт отдельной фичей baseline_time. В importance лидирует num_eval_data , суммарный объём валидации за прогон; рядом trainable params и политика сохранений. Ridge останавливается на MAE 7.23 ч, CatBoost и XGBoost сходятся около 1.7, 2 ч. 80% out-of-fold предсказаний в ±2.20 ч, 90% , в ±4.31 ч; до 60 ч медианная ошибка около часа или меньше. Хвост длинных runs (13 штук >60 ч) размазан сильнее. Только SFT и только H200 , цифры на другие GPU без переобучения не переносятся. Источник: Why your fine-tuning job takes longer than the FLOPs say .