 Экосистема AI Vibe


Длинные сессии открытых моделей: кэш префикса, harness и инференс
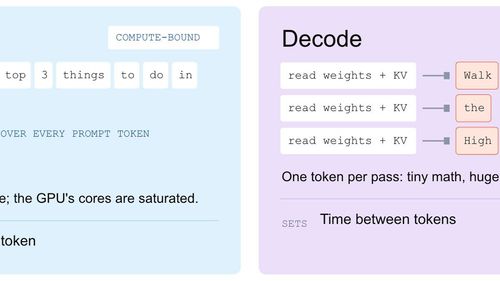
У кодинг-агента на каждом ходе в модель уходит почти вся сессия — системный промпт, определения инструментов, прочитанные файлы и результаты команд, а обратно приходит короткий вызов инструмента на пару десятков токенов. Без prefix caching движок снова прогоняет весь транскрипт, и Ollama вместе с Together AI разобрали, почему длинные задачи на открытых весах от этого дорожают и тормозят.
Запрос делится на prefill — параллельное чтение промпта до первого токена — и decode, где модель дописывает ответ по одному токену. В обычном чате заметны обе фазы; у агента почти всё время уходит на prefill, потому что вход растёт, а выход остаётся коротким. Prefix caching переносит идею KV-кэша между ходами: седьмой шаг — это шестой плюс хвост, и движку нужно досчитать только новое.
Счётчик работы на сессию
Кэш совпадает с начала промпта до первого отличающегося токена; всё после снова в работу. Дописывать в конец дешево, поменять символ выше по тексту — дорого. В идеализированной арифметике десять одинаковых ходов без кэша дают 1+2+…+10 = 55 единиц префилла, с кэшем — 10; на сотне ходов, что для кодинга не редкость, это 5050 против 100.
Где рвёт harness
- Поздняя подгрузка тулов. Вставить определение в список инструментов вверху — сбросить сотни тысяч токенов истории; безопаснее дописать в конец, если шаблон чата модели это принимает.
- Живой system prompt. Текущее время, git status или путь, который меняется каждый ход, превращают запрос в полное перечитывание.
- Reasoning effort в GLM-5.3-Flash. Уровень усилия вшит в первый системный блок; поднять low→high на длинной задаче почти обнуляет сессию — иногда выгоднее новый чат с нужным уровнем.
- Обрезка вывода тулов. Вернуть первые 100 строк из 640 без пояснения — модель не узнает, что функция на строке 420; явный диапазон и «осталось ещё N строк» экономят контекст на всех следующих ходах.
- Субагенты. Наследовать весь родительский контекст не всегда выгодно: префикс в кэше дешёвый в prefill, но каждый токен субагента всё равно тянет память GPU.
На стороне Ollama уже можно подключать привычные harness через ollama launch — в том числе к DeepSeek-V4.1-Flash и GLM-5.3-Flash, но перевод между API и ожиданиями harness остаётся частым источником срывов кэша.
Где теряется кэш в движке
Состояние сессии живёт на конкретном узле в конкретном дата-центре: следующий ход на другой машине заставляет заново прогонять префикс. Маршрутизация опирается на prompt_cache_key или хеш префикса; одинаковый system prompt между сессиями даёт шанс подхватить уже прогретую настройку, уникальные идентификаторы в шапке гарантируют холодный старт. На масштабе инференса те же длинные сессии давят на батчинг и размещение KV-памяти — отсюда continuous batching, paged KV и разнесённые кластеры prefill и decode.
Источник: Making open models work for long-horizon agentic workloads.