 Экосистема AI Vibe


Nemotron 3.5 Transcribe: один промпт — расшифровка, спикеры и перевод
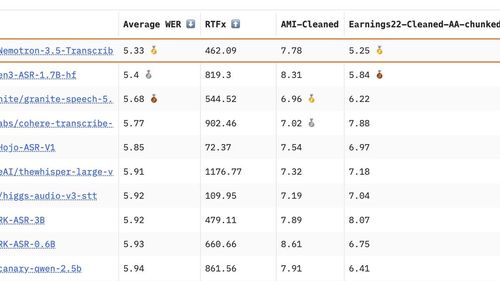
Nemotron 3.5 Transcribe — одна открытая модель для расшифровки записи, подписей спикеров, перевода и вопросов к аудио; NVIDIA выложила веса на Hugging Face и ModelScope. Формат ответа меняется текстовой инструкцией, без отдельного стека под каждую задачу.
Один чекпоинт — разные ответы
На одной записи можно попросить расшифровку со спикерами, перевод на английский или ответ вроде «какие решения приняли на встрече». Модель транскрибирует 40 языков, переводит 31 в паре с английским, размечает спикеров на 13 языках; до восьми голосов и до часа на файл. Редкую лексику задают в промпте — список терминов с условием использовать только то, что слышно в дорожке. Поддерживаются метки времени по словам; Q&A по аудио в основном для английского. Это про уже записанное аудио, не про живой стрим.
Метрики и где крутить
Среди open-weight моделей на Hugging Face Open ASR Leaderboard по английскому — 5,33% среднего WER. На Artificial Analysis — 2,8% AA-WER при около 4B активных параметров из 30B за счёт гибридного encoder и языковой модели с mixture-of-experts.
По diarization на David AI для 21 языка — DER 18,26%; на VoiceArena Diarization-Bench среди 14 систем — cpWER 32,4%. Запуск — через vLLM или локально NeMo-Speech.cpp, достаточно одной NVIDIA GPU. На RTX PRO 6000 Blackwell с NVFP4 авторы прогоняли 100 часов аудио меньше чем за три минуты на 30-секундных клипах при высокой конкуренции запросов.
Granary v2 и адаптация
За моделью — открытый датасет Granary v2: манифест на 463 062 часа, 48 языков и 16 корпусов, пайплайн NeMo Curator. На каждую запись готовят три формы текста — дословную, с заполнителями и «чистую»; те же стили можно запросить промптом у Transcribe.
- подготовка аудио и метаданные (сегменты, спикеры, язык);
- транскрипция с основной и резервной ASR и проверкой на галлюцинации;
- генерация вариантов текста, переводов и пар «инструкция — ответ»;
- фильтр HiFi для шумных и многоголосых фрагментов.
В медицинском кейсе NeMo Speech явное указание в промпте языка и латиницы снизило WER с 30,8% до 23,8% на полном бенчмарке; дообучение на репрезентативной речи дало ещё −45,8% относительно лучшего промпта на спикерах вне выборки.
Источник: NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription You Can Prompt and Adapt.