 Экосистема AI Vibe


Агент прошёл задачу один раз — на пятом повторе сорвался: разрыв Pass⁵
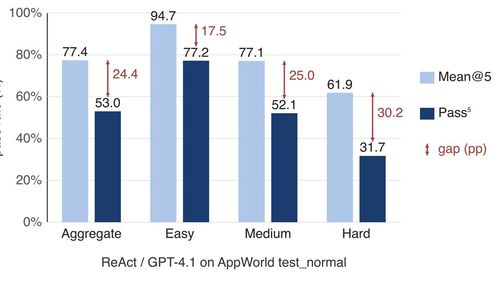
ReAct-агент с GPT-4.1 на AppWorld в среднем решает 77,4% задач за пять прогонов — но IBM Research показала, что все пять раз подряд он проходит лишь 53,0% задач. Разрыв в 24,4 пункта между «в среднем норм» и «можно положиться» — отдельная ось: более мощная модель его не закрывает.
Два разных вопроса
Лидерборды публикуют Mean@k: прогнать задачу k раз и усреднить успех. Pass⁵ спрашивает другое — какая доля задач прошла все k прогонов подряд. Pass@k оптимистичен (хватит одного успеха из k), Pass⁵ строгий: каждый запуск обязан пройти.
На сложных задачах разрыв доходит до 30 пунктов. На шагах вроде выбора API или аргумента ответы модели бывают почти равновероятны — и один промпт при temperature 0.0 на хостинге может разрешиться по-разному от запуска к запуску.
Диагностика и guidelines
В ALTK-Evolve появился новый тип правил — consistency guidelines. Consistency Analyzer берёт записанную траекторию и на каждом шаге решения делает один дополнительный вызов модели с k=5 завершениями, без новых tool calls и без повторного прогона задачи. Шаги с высокой вариативностью попадают в scorecard.
Из рискованных шагов собираются guidelines и подмешиваются в контекст при следующем запуске. Пример из AppWorld: считать чекбоксы в заметке regex-ом с якорем на строку, а не простым substring count. Нужен только trace — без логитов, без ground truth и без повторного прогона в среде.
Результаты
На test_normal (168 задач) guidelines из одной baseline-траектории на задачу подняли Pass⁵ с 53,0% до 69,0%, Mean@5 — с 77,4% до 81,0%. Разрыв сузился с 24,4 до 12,0 п.п.
На medium-сложности прирост Pass⁵ +22,9 п.п., на hard — +14,3 п.п.; средняя точность не просела ни на одном уровне. На похожей задаче в том же сценарии — +13,0 п.п. к Pass⁵. Toolkit с Consistency Analyzer выложен в open source.
Если выкатываете агента
- Считайте Pass^k рядом с Mean@k — даже k=3 покажет дыру, которую среднее скрывает.
- На самых сложных задачах разрыв шире — одна цифра «точности» там особенно обманчива.
- Не спешите менять модель: стабильность и способность модели — разные оси.
- Диагностика не требует grader и live replay — один дополнительный вызов LLM на шаг решения.
Источник: Your Agent Aced the Task. Will It Do It Again?.