 Экосистема AI Vibe


Playbook в промпте: GPT-4.1 лидирует на τ²-bench без дообучения
IBM Research с помощью ALTK-Evolve дописывает к доменной политике агента короткий playbook: gpt-4.1 смотрит на прошлые попытки на тренировочных задачах τ²-bench и превращает удачи и срывы в правила поведения. Веса модели не трогают, разметку руками не собирают — тот же gpt-4.1 и вытягивает правила, и ведёт диалог.
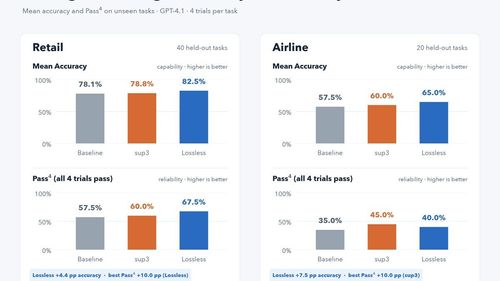
Проверка на customer service, не на кодинге: агент держится политики, зовёт инструменты (возврат, отмена, смена адреса) и получает бинарную оценку — совпало ли финальное состояние базы с ожидаемым. Бенчмарк τ²-bench от Sierra гоняет базовый ReAct с циклом THINK → ACT; симулятор клиента — gpt-5.5, по четыре trial на задачу. На retail с полным набором из 292 guidelines Pass^4 поднялся с 57,5% до 67,5%, и в снимке лидерборда от 12 октября 2026 запись обошла остальные retail-сабмишены.
Что попадает в промпт
Блок идёт после политики обычным markdown-списком. Типичные строки для retail:
- аутентификация до любого действия с заказом; без email — вызов
find_user_id_by_name_zip; - явное подтверждение перед любым изменением в базе;
- одно действие за шаг: не смешивать вызов инструмента и ответ пользователю в одном ходе.
У каждого правила есть support count — сколько разных train-задач его подтвердили. Вариант sup3 оставляет только правила с support ≥ 3 (31 guideline в retail, 14 в airline); lossless тащит всё после консолидации (292 и 101).
Тестовая выборка и цена контекста
На 40 retail test-задачах mean accuracy в lossless вырос с 78,1% до 82,5%; Pass^4 там же +10 п.п. В airline на 20 задачах полный список даёт лучшую accuracy (65%), но по надёжности выигрывает компактный sup3: Pass^4 45% против 40% у lossless — объём подсказок не универсальная крутилка.
Стоимость диалога в retail растёт с ~$0,084 до ~$0,139 (+65% за счёт input-токенов), при этом на одинаково успешных прогонах число ходов ассистента слегка падает (10,59 → 10,16). На airline с gpt-5.5 в роли агента те же learned guidelines дают +10 п.п. accuracy и +15 п.п. Pass^4 (55% → 70%) — прирост надёжности остаётся и на более сильной базовой модели.
Источник: ALTK-Evolve: How learned memory tops the τ²-bench leaderboard on customer service tasks without a frontier model.