 Экосистема AI Vibe


Async GRPO с LoRA на HF Jobs: bucket вместо NCCL между нодами
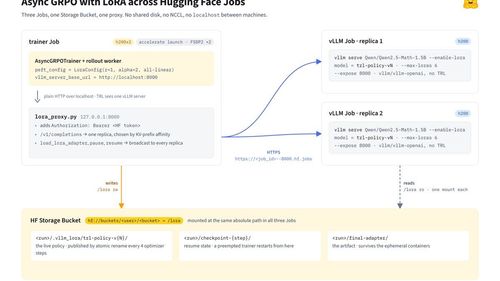
В TRL v1.14 AsyncGRPOTrainer научился синхронизировать с inference только LoRA-адаптер, а не всю модель. Для Qwen/Qwen2.5-Math-1.5B rank-1 , пара мегабайт против ~3 ГБ полной политики, поэтому тренер и vLLM могут крутиться на разных Hugging Face Jobs без NCCL и без общего localhost. Фича пришла с PR #7017. Адаптер пишется в Storage Bucket через FUSE-mount в каждом контейнере; vLLM подхватывает его с диска через /v1/load_lora_adapter , тензоры между Job по сети не гоняют. Как устроена схема Job с тренером и прокси на localhost:8000 , TRL не видит URL реплик vLLM Два vLLM Job на H200: базовая модель плюс до шести версий адаптера ( --max-loras 6 при max_staleness=4 ) Общий бакет по пути /lora , атомарный rename публикует версию trl-policy-v{N} Прокси добавляет заголовок авторизации HF и раздаёт загрузку адаптера всем репликам На датасете sail/Sanity-Test-R1D-1.5B (1 460 задач из MATH) команда Hugging Face прогнала пять конфигураций. На 500 шагах wall-clock сжался с 3 ч 27 мин до 53 мин , метрики AsyncGRPO показывают, где именно упирается прогон. Имена адаптеров версионируют намеренно: одно имя ломает prefix cache vLLM , префикс мог посчитаться под старыми весами, а декод пойти под новыми. trl-policy-v{N} привязывает кэш к конкретной версии весов. Источник: Async GRPO with LoRA across HF Jobs: a bucket, a proxy, and no NCCL .