 Экосистема AI Vibe


Разработка агента по eval: три шага вместо правок «на глаз»
Eval-driven development (EDD) — способ не гадать по одному удачному ответу в чате: LangChain свела цикл к трём шагам, близким по духу к test-driven development, но под агентов, где ответ и выбор тулов плавают от запуска к запуску. Метрики и сравнение экспериментов в LangSmith подменяют бесконечные правки промпта.
Обычный код детерминирован; агент — нет: один вопрос может дать разные формулировки, несколько ответов бывают верными, а лишний или пропущенный tool call всё равно может привести к «правильному» тексту. Eval гоняет агента по набору примеров и выставляет балл; жёсткие проверки — code eval, смысловые — LLM-as-a-judge. Такой подход LangChain уже использовали при сборке продвинутых агентов, в том числе в связке с IssueBench.
Три шага
- Зафиксировать «хорошо». Короткая спека на одно поведение: когда срабатывает, что агент делает и чего избегает, какие сценарии из PRD должны остаться рабочими — чтобы каждый кейс помечался pass или fail.
- Написать eval до фичи. Датасет из реальных прогонов или с нуля, эталонный вызов тула на пример; baseline-эксперимент в LangSmith до любых правок.
- Изменить агент и сравнить. Hill-climbing: новый эксперимент рядом с предыдущим; смотреть не только средний score, но и регрессии по отдельным примерам.
Где средний балл врёт
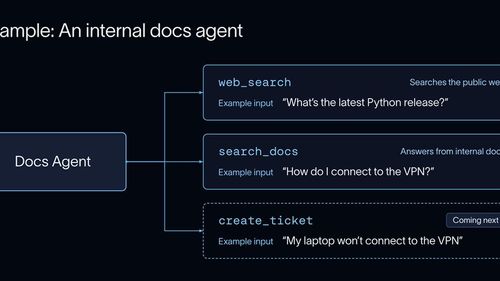
В примере — внутренний docs-агент с search_docs, web_search и планируемым create_ticket. По спеке «ноутбук не коннектится к VPN» должен заводить тикет; «как подключиться к VPN?» — искать в доках, не тикет. После добавления тула тикетные кейсы пошли в плюс, но how-to про VPN начал открывать тикет: средний балл вырос, поведение — нет. В trace видно слишком широкое описание create_ticket для «VPN and laptop issues»; после сужения формулировки проходят все примеры в датасете.
Для агентов, которые меняют состояние среды (кодинг в песочнице), проверки тулов и финального ответа мало — нужен чистый sandbox на каждый прогон. Open source-фреймворк Harbor лежит в основе бенчмарков вроде Terminal-Bench; при LangSmith Engine и бенчмарках Deep Agents команду гоняли через тот же цикл EDD на Harbor eval.
После baseline
Стопроцентный score на маленьком датасете не всегда цель: подгонка под те же примеры — переобучение. Held-out набор, который не трогаете при итерациях, показывает, не маскирует ли рост на «тюнинговых» кейсах провал на новых формулировках. Evals можно воткнуть в CI: LangSmith стыкуется с pytest и Vitest, прогон на каждый pull request; быстрые code-checks — на merge, тяжёлые с LLM-judge — ночью или перед релизом.
Источник: What Is Eval-Driven Development? How to Improve AI Agents.