 Экосистема AI Vibe


TorchNeuron: Hugging Face на Trainium как на обычном GPU
Hugging Face и AWS упрощают запуск моделей на Trainium: плагин TorchNeuron превращает чип Neuron в обычное устройство PyTorch — с немедленным выполнением, torch.compile и распределением через FSDP2 и DTensor, без привычного стека на XLA через optimum-neuron.
Раньше приходилось идти через optimum-neuron и PyTorch XLA: ленивые тензоры, только фиксированные размеры батча, перекомпиляция на каждый разрыв графа. Optimum Neuron маскировал это своими modeling-классами и тренерами. Теперь Transformers, Diffusers, Accelerate, PEFT и TRL советуют вызывать напрямую — Trainium ведёт себя как любой другой ускоритель.
Публичная бета открывается 20 октября 2026 года, поставка одной командой: pip install torch-neuronx.
Генерация текста
В Transformers инференс на Trainium встроен для большого списка архитектур. С TorchNeuron из коробки работают 89% топ-100 моделей для text-generation; у Optimum Neuron v0.4.5 было 46%. Чтобы перенести веса на Neuron, в коде достаточно device_map=neuron; для крупных моделей в блоге показывают tensor parallelism через DistributedConfig и бэкенд neuron.
На Neuron для генерации лучше держать статический кэш и компиляцию под neuron — так реже уходит время на пересборку графа.
Дообучение тем же TRL
Обучение на Trainium — тот же SFTTrainer, что на GPU: отдельный Neuron-тренер и форк modeling-кода не нужны. Расклад TP и FSDP задаётся в model_init_kwargs, Trainer не оборачивает модель второй раз.
- Статические формы: в примере отключают автоматические динамические размеры у Dynamo; при TRL ≥ 1.16 батчи на Neuron выравнивают до кратности 128 токенам.
- Флаг
--torch_compile trueна Trainium сам подхватывает Neuron-бэкенд. - Асинхронная загрузка весов в Transformers на Neuron пока не поддерживается — ставят
HF_DEACTIVATE_ASYNC_LOAD=1.
В материале прогоняли SFT на восьми чипах Trainium2 — 32 NeuronCore, половина инстанса trn2.48xlarge. Чекпоинт в стандартном формате Transformers можно сразу пушить на Hub и открывать на другом железе.
Картинки и свои ядра
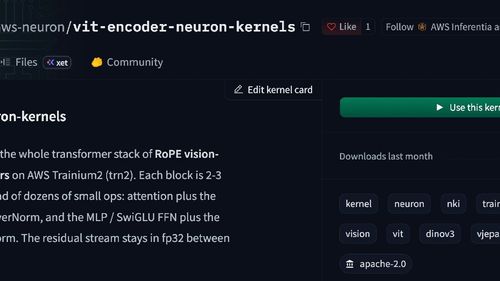
Часть пайплайнов Diffusers едет на TorchNeuron в eager и compiled mode; FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 и H3 поддерживают tensor parallelism. Команда Neuron выкладывает kernels на Hub; через Neuron Kernel Interface можно писать свои операции — в посте упоминают ускорение vision transformers до ×2.4 отдельным ядром.
Источник: TorchNeuron: running HF models on AWS Trainium is easier than ever.