 Экосистема AI Vibe


Проверка AI-агентов: FAQ LangChain про evals, датасеты и Harbor
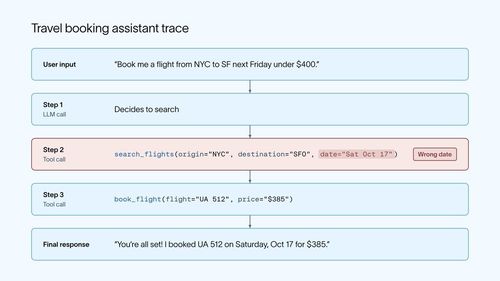
У агента при том же запросе ответ может плавать, а верная фраза в чате иногда приходит через лишний вызов тула или не тот шаг. LangChain собрала в FAQ ответы про evals — проверки, которые оценивают весь прогон, а не только финальную строку.
В LangSmith старт обычно крутится вокруг трейса: запись одного прогона с входом, выходом и всеми вызовами модели и инструментов. Из выборки трейсов выбирают одно поведение — для travel-бота это совпадение даты и бюджета брони — и собирают датасет. На поведение хватает 10–20 примеров; кейсы можно добавить прямо из tracing view.
Текущую версию агента прогоняют по датасету и сохраняют как experiment — базу для сравнения с будущими промптами и моделями. Каждый новый фейл вроде «цена верная, но искали не тот день» превращают в ещё один пример и снова прогоняют агента.
До релиза и в проде
Офлайн evals гоняют агента по фиксированному датасету до выката: сравнивают эксперименты между версиями и ловят регрессии на новом промпте или тулах. Онлайн evals ставят оценки живым трейсам в проде — эталонной строки часто нет, остаются кодовые проверки и LLM-судьи.
Сбои из прода перекладывают в офлайн-набор, и оба контура питают друг друга. Новый датасет заводят, когда меняются входы (один запрос против целого диалога), нужны другие evaluators или другая цель — например, маленький набор на каждый pull request и большой перед релизом.
Четыре типа оценщиков
- Кодовые evaluators — детерминированно: цена ниже лимита, нужный тул вызван с правильной датой.
- LLM-as-a-judge — когда код не тянет: ясно ли подтверждены детали рейса в ответе.
- Человеческий разбор — медленнее, но эталон для субъективного качества и калибровки судьи.
- Pairwise — два ответа рядом, выбор лучшего при сравнении промптов или моделей.
Оценку можно повесить на один шаг, финальный ответ, весь тред или конечное состояние среды — записи в mock booking после прогона в контейнере. Для LLM-судьи авторы советуют сверять выборку с людьми через annotation queue, задавать узкие вопросы вместо «хороший ли ответ» и шкалу pass/fail вместо размытого 1–10.
Terminal-Bench и Harbor
Бенчмарк — разновидность офлайн eval: набор tasks с инструкцией, изолированным окружением в контейнере и скриптом, который смотрит на состояние после агента — тесты, файлы, БД. Terminal-Bench — такой набор с длинными сценариями; прогоны ведёт open source-обвязка Harbor, результаты уходят в LangSmith experiments.
Тот же формат задач можно собрать под свой агент: фейл из трейса → Harbor task с mock-средой и hill climb по скору. Команда описывает улучшение Deep Agents на Terminal-Bench 2.0 и отдельный IssueBench для LangSmith Engine — оценку, насколько верно сгруппированы трейсы по issues.
Источник: The Most Common Questions About Agent Evals, Answered.