 Экосистема AI Vibe


Ising вместо рейтинга блоков: Llama-70B на половине глубины держит MMLU
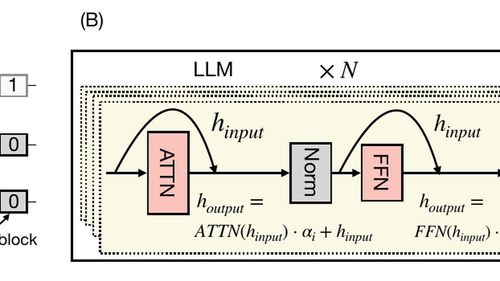
Целые блоки трансформера можно вырезать из стека — модель короче, ответы быстрее, и это стыкуется с квантизацией и low-rank сжатием. Multiverse Computing свела выбор слоёв к оптимизации с фиксированным числом удалений: после одного расчёта матрицы взаимодействий на калибровочных данных каждый кандидат оценивается одной дешёвой энергией, без прогона полной модели и без MMLU на каждой комбинации.
Диагональ матрицы Гессе — вклад блока сам по себе, внедиагональ — как связаны решения по соседним слоям. Эвристики вроде block influence по сути смотрят блоки по отдельности; здесь это задача constrained binary optimization, эквивалентная поиску низкой энергии в модели Изаинга с заданным числом «удалённых» спинов.
Как ищут конфигурации
- На одной GPU перебирают до десятков миллиардов состояний; снятие 8 из 80 блоков Llama-3.3-70B (~29 млрд вариантов) заняло около двух суток.
- На больших пространствах — QUBO и tabu search: секунды вместо полного перебора, самый низкий уровень энергии не обязателен.
- На Llama-3.1-8B-Instruct при 16 из 32 удалённых блоков 17-е возбуждённое состояние после лёгкого дообучения обошло ground state на бенчмарках.
Цифры без дообучения
У Llama-3.3-70B-Instruct исходный MMLU — 82,2. При 32 из 80 удалённых блоков CBO даёт 76,6 против 59,3 у block influence; при 40 из 80 (половина глубины) — 76,9 против 54,0 — почти 23 пункта разрыва на MMLU. На Qwen3-14B при 12 из 40 удалённых CBO ведёт примерно на 10 пунктов.
Тот же приём проверили на гибриде NVIDIA Nemotron-3-Nano-30B (Mamba2, attention, MoE) без дообучения. Реализация открыта в CompactifAI/Block_removal_through_constrained_binary_optimization.
Источник: Pruning LLMs Like a Physicist: Block Removal as an Ising Optimization Problem.