 Экосистема AI Vibe


NVIDIA: 2,8 трлн токенов индийских языков и открытый рецепт претрейна
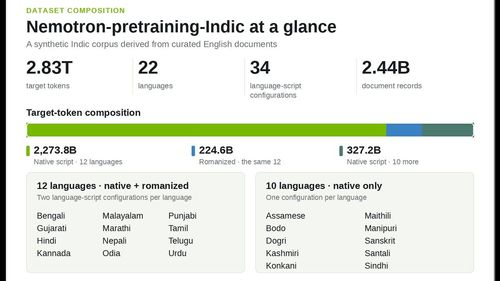
NVIDIA с лабораторией AI4Bharat при IIT Madras открывает корпус Nemotron-pretraining-Indic-v1 — около 2,8 трлн токенов на 22 языка из конституционного списка Индии — и GPU-конвейер на NeMo Data Designer. Для тех, кто крутит свой претрейн: вместе с данными уезжает рецепт — промпты, LLM-воркфлоу и проверки качества, которые можно перенастроить под свои исходники.
В смесь попадают переводы английских материалов из 15 подмножеств Nemotron-CC-v2: веб, вопросы-ответы, математика, код. Каждая запись привязана к исходному документу, выход сверяют с ним — чтобы синтетика про код и формулы не «поплыла».
Как устроен конвейер
Для двенадцати языков — четыре стадии: полнодокументный перевод моделью Gemma-4-31B-it, оценка по рубрике в духе Multidimensional Quality Metrics, починка слабых мест и, для части принятых переводов, конвертация в латиницу с проверкой против родного скрипта.
- В проход идут только переводы не ниже 75 из 100 по рубрике (смысл, беглость, термины, стиль, вёрстка); код, формулы и URL в промптах помечают как «сохранить».
- После цикла repair вернули 438,4 млрд токенов — они уже входят в общий объём корпуса.
- Для остальных десяти языков — Indic Translate от Bodhan AI и те же проверки; у Santali — перевод перекрывающимися окнами, у Manipuri — цепочка через бенгальское письмо в Meitei Mayek.
По токенизатору Gemma-4 в корпусе 2601,0 млрд токенов в родной письменности и 224,6 млрд в латинской транслитерации — всего 34 конфигурации «язык + письмо».
Что дало смешение в Nemotron 3.5 Super VL
На этапе continued pretraining в смесь добавили 10 млрд индийских токенов — 10% от бюджета 100 млрд на этой стадии. На пяти индийских бенчмарках (MILU, Indic MMLU-Pro, Indic ARC-Challenge/Easy, Indic GSM8K) прирост после этапа — от 4,98 до 9,82 процентных пункта; в отчёте отдельно говорят про эффект смеси синтетики и естественного текста, а не одного корпуса.
Источник: Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline.