 Экосистема AI Vibe


Локальная Qwen3.8-27B: без reasoning сумма «словами» — 23,57%
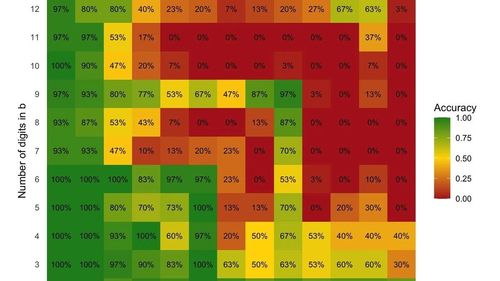
Simon Willison повторил на DGX Spark бенчмарк Colin Frasier: локальная Qwen3.8-27B-Q4_K_M.gguf должна сложить два положительных числа и вернуть сумму только английскими словами. Без рассуждений модель часто попадает в нужный формат и при этом промахивается в самой арифметике. В прогоне без reasoning , 5 070 задач, по 30 пар на каждую ячейку теплокарты (разрядность a и b от 1 до 13) , точных сумм набралось 23,57%. Формат при этом держится в 96,17% случаев. На коротких слагаемых точность около 97,04%, на десяти, тринадцатизначных падает до 6,44%. Willison воспроизвёл сетку через Codex Remote (GPT-6 Astra), опираясь на двухлетний эксперимент Frasier с GPT-4o. С включённым medium reasoning Второй заход , по одной попытке на ячейку, 169 пар , дал 167 верных из 169. В трассах на больших числах модель выравнивает столбцы, считает переносы и пишет вроде «подождите, пересчитаю аккуратнее» , явное пошаговое сложение, а не угадывание итога. На теплокарте без рассуждений длинные разряды уходят в красную зону; с reasoning почти вся сетка синяя, кроме двух ячеек с нулём (a=2, b=8 и a=12, b=9). Willison отдельно предупреждает: при одном шоте на клетку повторный прогон мог бы перекрасить эти квадраты. Источник: Qwen3.8 27B addition in words .