 Экосистема AI Vibe


RMSNorm на Trainium: в шесть раз быстрее после fuse или torch.compile
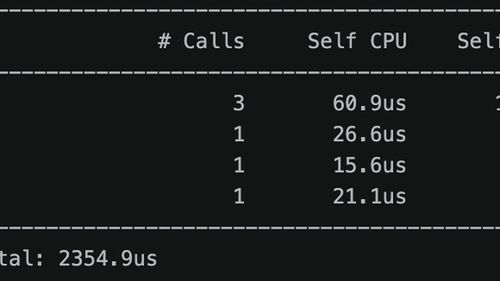
Где inference на Trainium реально теряет время, это видно в трассах, а не по ощущениям. Amazon в первой части серии про TorchNeuron разобрала пример на RMSNorm: шесть отдельных dispatch операторов против одного слитого ядра , на устройстве между вариантами примерно шестикратный разрыв. Как снять профиль без пустой колонки Neuron TorchNeuron цепляется к PyTorch через PrivateUse1: в torch.profiler добавляют ProfilerActivity.PrivateUse1 , в experimental_config передают NeuronConfig с режимами device и runtime и correlate_device_time=True , а трассу пишет NeuronProfiler через export_trace . В цикле профилирования вызывают torch.neuron.synchronize() , иначе экспорт успевает раньше устройства, и Neuron time в отчёте пустой. Таблицу key_averages() сортируют по self_privateuse1_time_total ; в Neuron Explorer одна операция идёт от framework dispatch через nrta_execute_schedule до nc_exec_running на NeuronCore. Три способа посчитать одну нормализацию Пошаговый eager , отдельные mul , mean , rsqrt на тензорах 4×512 в bfloat16; шесть operator calls, Self NEURON 2 355 мкс. Три aten::mul забирают около 49,5% device time. torch.rms_norm , одно ядро aten::_fused_rms_norm , 403,3 мкс на Neuron. Тот же наивный код с torch.compile(backend='neuron') , TorchDynamo строит FX-граф, бэкенд компилирует один NEFF; в отчёте Torch-Compiled Region, 375,5 мкс. В eager-варианте каждая операция сама проходит путь framework → runtime → железо, плюс промежуточные значения вроде x_sq . Fuse и compile сводят расчёт к одному hardware dispatch , отсюда ускоренные варианты укладываются примерно в шестую часть naive по Neuron time. Воспроизвести прогоны можно в каталоге примеров torch-neuronx . Источник: Profiling TorchNeuron (Part 1): System-level profiling on AWS Trainium.